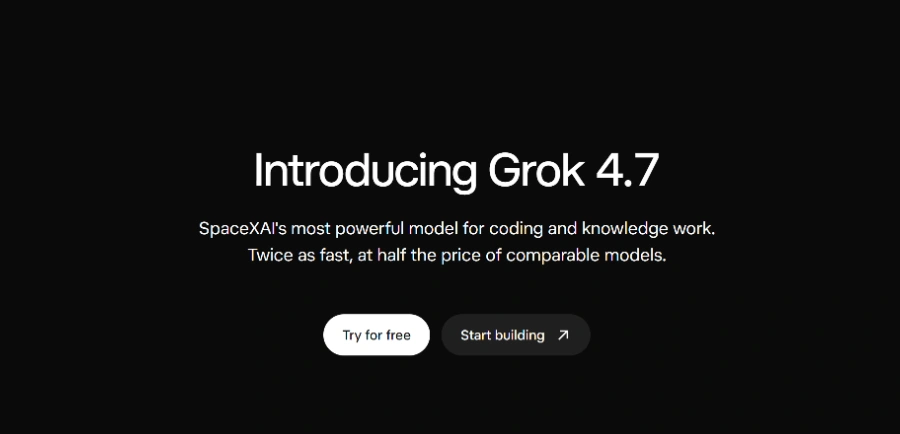
« Un modèle de raisonnement deux fois plus rapide et moitié moins cher, qui travaille plus longtemps sur les tâches difficiles, vérifie mieux son propre travail et résiste fortement aux tentatives de contournement. Il s'intègre facilement à Cursor ou via API »
Grok 4.7 : SpaceXAI muscle son modèle de code sans toucher au tarif
Mis à jour le 24 septembre 2026
Grok 4.7 est le modèle frontière de SpaceXAI (ex-xAI) pour le code, les agents et le travail intellectuel, successeur direct de Grok 4.6. Il est arrivé la veille de Claude Opus 5.5 et de GPT-6 Sol, avec un tarif API inchangé de 2 $ le million de tokens en entrée (environ 1,85 €). Sa fenêtre de contexte grimpe à 500 000 tokens, avec entrée texte et image. Bonne nouvelle côté francophone, le modèle tient la conversation en français, même si la documentation développeur reste en anglais.
Avantages
Contexte de 500 000 tokens pour les gros dépôts
Tarif API identique à celui de Grok 4.6
Palier gratuit dans Grok Build
Quatre niveaux d'effort de raisonnement, dont xhigh
Recherche web, recherche X et exécution de code intégrées
Inconvénients
Benchmarks publiés par SpaceXAI seul, à recouper
Consommation de tokens élevée sur les longues tâches d'agent
Variante Fast absente de l'API publique
Grok 4.7 vs Grok 4.6, ce qui change sous le capot
Grok 4.7 repose sur une base de modèle plus grande que celle de Grok 4.6, entraînée par un apprentissage par renforcement plus long sur des tâches qui demandent des heures. Selon SpaceXAI, il vérifie mieux son propre travail, tient les contextes très longs et comprend nativement le harnais Grok Bot pour les échanges conversationnels. Une pile de garde-fous refondue et des capacités en cybersécurité complètent la mise à jour.
Dans la pratique, vous appelez l'identifiant grok-4.7, vous choisissez un des quatre niveaux d'effort de raisonnement, et l'API Responses renvoie le raisonnement chiffré pour enchaîner les tours sans rien reconfigurer. Appel de fonctions, recherche web, recherche X et exécution de code sont de série, avec des connaissances arrêtées à mai 2026. Vous collez un dépôt entier dans le contexte, vous décrivez le bug, l'agent déroule. Le modèle est aussi disponible dans Cursor, où une variante Fast double la vitesse de sortie.
Grok 4.7 passé au crible, test sans battage (en anglais)
Grok 4.7, le modèle frontière le moins cher du moment ? (en anglais)
Des benchmarks maison dans une semaine à trois lancements
SpaceXAI annonce 71,0 % sur DeepSWE v1.1 et 46,3 % sur CursorBench 4.0, des scores mesurés au niveau d'effort xhigh et publiés par la maison fondée en 2023 par Elon Musk sous le nom xAI. Des mesures indépendantes restent donc attendues pour confirmer la copie.
Le calendrier n'a rien d'anodin. Le modèle est sorti la veille de Claude Opus 5.5, facturé 4 $ et 20 $ le million de tokens, et de GPT-6 Sol, à 2 $ et 10 $. Les trois ne passent pas les mêmes épreuves, prudence donc avant de sacrer un vainqueur, et le classement des modèles de langage aide à suivre la hiérarchie au fil des semaines.
Benchmark
Score annoncé
Terrain testé
DeepSWE v1.1
71,0 %
Ingénierie logicielle
CursorBench 4.0
46,3 %
Tâches de code de longue durée
Terminal-Bench 4.0
37,6 %
Travail en terminal sur plusieurs heures
HealthBench Professional
56,7 %
Questions de santé professionnelles
Harvey Legal Agent Benchmark
19,6 %
Travail juridique agentique
Grok 4.7 prix, accès et mot au public francophone
L'API publique facture Grok 4.7 2 $ le million de tokens en entrée et 6 $ en sortie (environ 1,85 € et 5,55 €), le même barème que Grok 4.6. La variante Fast, deux fois plus rapide pour deux fois plus cher, reste cantonnée à Cursor et Grok Build, ce dernier proposant par ailleurs un accès gratuit au modèle standard. On retrouve grok-4.7 sur OpenRouter, Vercel et Cloudflare. La disponibilité sur grok.com et dans X, formules Premium et SuperGrok comprises, n'est pas détaillée dans les pages officielles, un tour sur grok.com s'impose. Ces barèmes bougent vite, seule la page de tarifs de SpaceXAI fait foi.
Pour jauger le rapport prix-performance hors chiffres maison, des sites de mesure comme Artificial Analysis publient leurs propres relevés de vitesse et de coût par tâche (utile, car un token bon marché qui en consomme des milliers ne l'est plus tant que ça). Et si vous travaillez en français, le modèle suit sans broncher, seuls les messages d'erreur de votre terminal resteront anglophones.
Grok 4.7 est le modèle frontière de SpaceXAI pour le code, les tâches agentiques et le travail intellectuel, successeur de Grok 4.6. Il accepte texte et images en entrée, dispose d'une fenêtre de 500 000 tokens et s'utilise via l'API Grok, Cursor, Grok Build, OpenRouter, Vercel et Cloudflare.
Combien coûte Grok 4.7 ?
Sur l'API, comptez 2 $ le million de tokens en entrée et 6 $ en sortie, soit environ 1,85 € et 5,55 €, comme Grok 4.6. La variante Fast coûte le double et n'existe que dans Cursor et Grok Build. Les prix des abonnements grand public restent à vérifier sur grok.com.
Quelle différence entre Grok 4.7 et Grok 4.6 ?
Une base de modèle plus grande, un apprentissage par renforcement prolongé sur des tâches ardues, une meilleure vérification de son propre travail et une gestion renforcée du contexte long, à prix identique. La documentation de SpaceXAI propose des guides de migration depuis Grok 4.6.
Grok 4.7 ou Claude Opus 5.5, lequel choisir ?
Tout dépend de votre budget et de vos propres tests. Opus 5.5, sorti le lendemain, est facturé 4 $ en entrée et 20 $ en sortie par million de tokens, contre 2 $ et 6 $ pour Grok 4.7. Les deux éditeurs ne publient pas les mêmes benchmarks, le plus fiable reste d'essayer chacun sur vos dépôts.
Verdict : Deux dollars le million de tokens en entrée pour un modèle frontière, la calculatrice tranche vite. Développeurs sous Cursor, équipes qui font tourner des agents de code à longueur de journée et curieux de veille IA y trouveront un banc d'essai à prix contenu, en attendant les mesures indépendantes.
Afin de fournir une expérience optimale, Aixploria utilise des technologies telles que les cookies pour stocker et/ou accéder aux informations relatives à l'appareil. En acceptant ces technologies, vous nous permettez de traiter des données telles que le comportement de navigation ou des identifiants uniques sur ce site.
Fonctionnel
Toujours activé
Le stockage ou l’accès technique est strictement nécessaire dans la finalité d’intérêt légitime de permettre l’utilisation d’un service spécifique explicitement demandé par l’abonné ou l’internaute, ou dans le seul but d’effectuer la transmission d’une communication sur un réseau de communications électroniques.
Préférences
Le stockage ou l’accès technique est nécessaire dans la finalité d’intérêt légitime de stocker des préférences qui ne sont pas demandées par l’abonné ou la personne utilisant le service.
Statistiques
Le stockage ou l’accès technique qui est utilisé exclusivement à des fins statistiques.Le stockage ou l’accès technique qui est utilisé exclusivement dans des finalités statistiques anonymes. En l’absence d’une assignation à comparaître, d’une conformité volontaire de la part de votre fournisseur d’accès à internet ou d’enregistrements supplémentaires provenant d’une tierce partie, les informations stockées ou extraites à cette seule fin ne peuvent généralement pas être utilisées pour vous identifier.
Marketing
Le stockage ou l’accès technique est nécessaire pour créer des profils d’internautes afin d’envoyer des publicités, ou pour suivre l’internaute sur un site web ou sur plusieurs sites web ayant des finalités marketing similaires.
Pour offrir les meilleures expériences, nous utilisons des technologies telles que les cookies pour stocker et/ou accéder aux informations des appareils. Le fait de consentir à ces technologies nous permettra de traiter des données telles que le comportement de navigation ou les ID uniques sur ce site. Le fait de ne pas consentir ou de retirer son consentement peut avoir un effet négatif sur certaines caractéristiques et fonctions.
Fonctionnel
Toujours activé
Le stockage ou l’accès technique est strictement nécessaire dans la finalité d’intérêt légitime de permettre l’utilisation d’un service spécifique explicitement demandé par l’abonné ou l’internaute, ou dans le seul but d’effectuer la transmission d’une communication sur un réseau de communications électroniques.
Préférences
Le stockage ou l’accès technique est nécessaire dans la finalité d’intérêt légitime de stocker des préférences qui ne sont pas demandées par l’abonné ou la personne utilisant le service.
Statistiques
Le stockage ou l’accès technique qui est utilisé exclusivement à des fins statistiques.Le stockage ou l’accès technique qui est utilisé exclusivement dans des finalités statistiques anonymes. En l’absence d’une assignation à comparaître, d’une conformité volontaire de la part de votre fournisseur d’accès à internet ou d’enregistrements supplémentaires provenant d’une tierce partie, les informations stockées ou extraites à cette seule fin ne peuvent généralement pas être utilisées pour vous identifier.
Marketing
Le stockage ou l’accès technique est nécessaire pour créer des profils d’internautes afin d’envoyer des publicités, ou pour suivre l’internaute sur un site web ou sur plusieurs sites web ayant des finalités marketing similaires.


 GPT-6 Astra
 Claude Fable 5.1
 Claude Opus 5.5