« Le plus rapide et le plus abordable des modèles Claude en version 5, taillé pour les tâches à fort volume comme le tri, le résumé ou l'extraction d'informations. Ce modèle privilégie la rapidité, les faibles coûts et une utilisation fluide des navigateurs ou des outils »
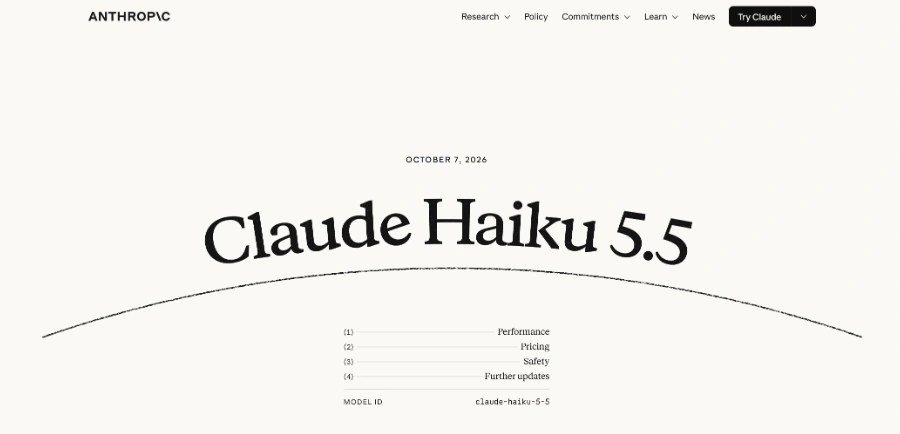
Claude Haiku 5.5 : dix fois moins cher et bien plus capable que son prédécesseur
Mis à jour le 13 octobre 2026
Claude Haiku 5.5 est le petit modèle rapide d'Anthropic, conçu pour les tâches répétitives et sensibles au coût comme la classification, le résumé de documents ou le support client en temps réel. Sorti le 7 octobre 2026, il complète la famille de modèles lancée en 2023 aux côtés d'Opus 5.5 et Sonnet 5.5. Le tarif API démarre à 0,10 $ le million de tokens en entrée (environ 0,09 €) pour les requêtes courtes, soit une baisse de 90 % par rapport à Haiku 4.5. Le modèle comprend et rédige en français, même si les annonces d'Anthropic restent en anglais.
Avantages
Tarif d'entrée divisé par dix sur les requêtes courtes
Premier Haiku avec réglage du niveau d'effort
Fenêtre de contexte d'un million de tokens
Lecture de cache à 0,01 $ le million de tokens
Disponible sur quatre clouds dès la sortie
Inconvénients
Au-delà de 100 000 tokens le tarif remonte à 0,50 $/2,50 $
Nettement derrière Sonnet 5.5 sur le code agentique
Documentation et annonces restent en anglais
Claude Haiku 5.5 face à GPT-6 Luna et Sonnet 5.5
Selon les benchmarks publiés par Anthropic, Haiku 5.5 dépasse GPT-6 Luna sur six évaluations partagées. L'écart est spectaculaire sur OSWorld 2.1 (contrôle d'un bureau virtuel) avec 72,4 % contre 48,9 %, et sur Terminal-Bench 4.0 avec 39,2 % contre 16,4 %. L'index Artificial Analysis, mesure indépendante, attribue un score d'intelligence de 43 à Haiku 5.5 contre 38 à Luna.
L'écart avec le grand frère Sonnet 5.5 reste net sur le code agentique (39,2 % contre 70,6 % sur Terminal-Bench), ce qui cantonne Haiku aux tâches de routine pendant que Sonnet ou Opus pilotent la stratégie. Anthropic le présente d'ailleurs comme un sous-agent qui épaule Opus 5.5 et Sonnet 5.5 sur le code, pas comme remplaçant des modèles de langage de milieu ou haut de gamme.
Benchmark
Haiku 5.5
GPT-6 Luna
Sonnet 5.5
GDPval-AA v2.1 (Elo)
1 620
1 437
1 840
OSWorld 2.1
72,4 %
48,9 %
83,9 %
Terminal-Bench 4.0
39,2 %
16,4 %
70,6 %
FrontierCode 1.1
46,4 %
42,4 %
52,1 %
Chartography
46,4 %
29,1 %
61,6 %
Prise en main de Claude Haiku 5.5, en anglais
Effort réglable et cas d'usage concrets
Haiku 5.5 est le premier modèle Haiku à proposer un réglage du niveau d'effort, du mode le plus économique au mode le plus profond. En pratique, vous tapez une question simple, le modèle répond en quelques centaines de millisecondes. Montez l'effort d'un cran pour un raisonnement plus poussé, le tout sans changer de modèle.
Asana rapporte plus de 30 % de latence en moins par rapport à la version précédente. Box constate 11 points de qualité supplémentaires pour environ la moitié du temps de réponse. Ces retours confirment le positionnement du modèle sur les tâches en volume, du tri de tickets au résumé de rapports en passant par la navigation web automatisée.
Tarifs API et accès à Claude Haiku
Pour les requêtes jusqu'à 100 000 tokens (environ 90 % du trafic selon Anthropic), le million de tokens en entrée coûte 0,10 $ et en sortie 0,50 $. La lecture de cache tombe à 0,01 $. Au-delà de cette limite, les prix passent à 0,50 $ et 2,50 $, soit tout de même 50 % de moins que Haiku 4.5.
L'identifiant de modèle est claude-haiku-5-5, accessible depuis l'API Anthropic, Amazon Bedrock, Google Cloud et Microsoft Azure. Les abonnés Max et Team reçoivent des crédits API mensuels valables sur tous les modèles Claude. Les tarifs évoluent selon les annonces d'Anthropic, le site officiel reste la source de référence pour les grilles en vigueur.
Haiku 5.5 à 0,10 $/0,50 $ par million de tokens convient aux tâches en volume comme le tri, la classification ou le résumé. Sonnet 5.5 à 2 $/10 $ vise le code agentique et les projets longs, avec 70,6 % sur Terminal-Bench contre 39,2 % pour Haiku. Le choix dépend du compromis entre coût par requête et profondeur de raisonnement attendue.
Claude Haiku 5.5 est-il bon pour coder ?
Sur FrontierCode 1.1, Haiku 5.5 atteint 46,4 %, au-dessus de GPT-6 Luna (42,4 %). Pour des corrections ponctuelles, du prototypage rapide ou des sous-tâches déléguées par un modèle principal, il tient la route. Les refontes complexes de code restent mieux servies par Sonnet 5.5 ou Opus 5.5 selon les retours de terrain.
Combien coûte Claude Haiku 5.5 ?
Le tarif démarre à 0,10 $ le million de tokens en entrée et 0,50 $ en sortie pour les requêtes de moins de 100 000 tokens. Au-delà, les prix passent à 0,50 $ et 2,50 $. La lecture de cache descend à 0,01 $ par million. Les abonnés Max et Team disposent en prime de crédits API mensuels valables sur ce modèle.
Quelle différence entre Opus, Sonnet et Haiku chez Claude ?
Trois niveaux de puissance et de prix. Opus 5.5 (4 $/20 $ par million de tokens) est le plus puissant, suivi par Sonnet 5.5 (2 $/10 $) pour les tâches exigeantes et Haiku 5.5 (0,10 $/0,50 $) pour le volume. Sur GDPval-AA v2.1, les scores Elo sont respectivement autour de 1 846, 1 840 et 1 620.
Verdict : Résumer des centaines de documents, trier des tickets ou piloter un navigateur sans exploser la facture API, voilà le terrain de Claude Haiku 5.5. Les équipes qui traitent un fort volume de requêtes courtes y trouveront un rapport performances-prix difficile à battre, à condition de confier les raisonnements longs à Sonnet ou Opus.
Afin de fournir une expérience optimale, Aixploria utilise des technologies telles que les cookies pour stocker et/ou accéder aux informations relatives à l'appareil. En acceptant ces technologies, vous nous permettez de traiter des données telles que le comportement de navigation ou des identifiants uniques sur ce site.
Fonctionnel
Toujours activé
Le stockage ou l’accès technique est strictement nécessaire dans la finalité d’intérêt légitime de permettre l’utilisation d’un service spécifique explicitement demandé par l’abonné ou l’internaute, ou dans le seul but d’effectuer la transmission d’une communication sur un réseau de communications électroniques.
Préférences
Le stockage ou l’accès technique est nécessaire dans la finalité d’intérêt légitime de stocker des préférences qui ne sont pas demandées par l’abonné ou la personne utilisant le service.
Statistiques
Le stockage ou l’accès technique qui est utilisé exclusivement à des fins statistiques.Le stockage ou l’accès technique qui est utilisé exclusivement dans des finalités statistiques anonymes. En l’absence d’une assignation à comparaître, d’une conformité volontaire de la part de votre fournisseur d’accès à internet ou d’enregistrements supplémentaires provenant d’une tierce partie, les informations stockées ou extraites à cette seule fin ne peuvent généralement pas être utilisées pour vous identifier.
Marketing
Le stockage ou l’accès technique est nécessaire pour créer des profils d’internautes afin d’envoyer des publicités, ou pour suivre l’internaute sur un site web ou sur plusieurs sites web ayant des finalités marketing similaires.
Pour offrir les meilleures expériences, nous utilisons des technologies telles que les cookies pour stocker et/ou accéder aux informations des appareils. Le fait de consentir à ces technologies nous permettra de traiter des données telles que le comportement de navigation ou les ID uniques sur ce site. Le fait de ne pas consentir ou de retirer son consentement peut avoir un effet négatif sur certaines caractéristiques et fonctions.
Fonctionnel
Toujours activé
Le stockage ou l’accès technique est strictement nécessaire dans la finalité d’intérêt légitime de permettre l’utilisation d’un service spécifique explicitement demandé par l’abonné ou l’internaute, ou dans le seul but d’effectuer la transmission d’une communication sur un réseau de communications électroniques.
Préférences
Le stockage ou l’accès technique est nécessaire dans la finalité d’intérêt légitime de stocker des préférences qui ne sont pas demandées par l’abonné ou la personne utilisant le service.
Statistiques
Le stockage ou l’accès technique qui est utilisé exclusivement à des fins statistiques.Le stockage ou l’accès technique qui est utilisé exclusivement dans des finalités statistiques anonymes. En l’absence d’une assignation à comparaître, d’une conformité volontaire de la part de votre fournisseur d’accès à internet ou d’enregistrements supplémentaires provenant d’une tierce partie, les informations stockées ou extraites à cette seule fin ne peuvent généralement pas être utilisées pour vous identifier.
Marketing
Le stockage ou l’accès technique est nécessaire pour créer des profils d’internautes afin d’envoyer des publicités, ou pour suivre l’internaute sur un site web ou sur plusieurs sites web ayant des finalités marketing similaires.


 Claude Opus 5.5
 GPT-6 Astra
 Claude Fable 5.1