GLM-5.3-Flash
#23 dans Modèles LLM
« Le premier modèle nativement multimodal de la famille GLM-5, capable d'observer des interfaces et de coder en s'appuyant sur ce qu'il voit, avec un contexte d'1 million de tokens à coût très réduit»



Mis à jour le 29 août 2026
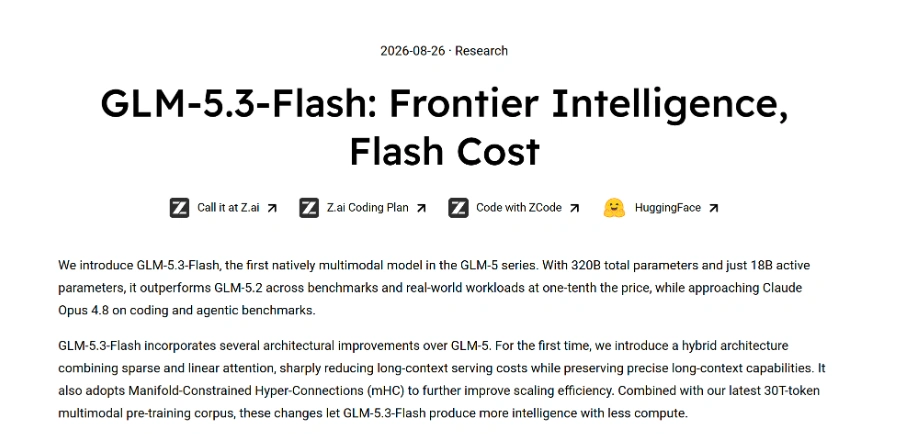
GLM-5.3-Flash est le premier modèle nativement multimodal de la série GLM-5 de Z.ai, capable de lire du texte, des images et de la vidéo dans une fenêtre d'un million de tokens. Avant son annonce officielle, il a circulé incognito sous le pseudonyme Ox Alpha sur OpenRouter, où il est devenu le modèle le plus utilisé de la semaine. Ses poids sont publiés sous licence MIT et son API se facture 0,15 $ le million de tokens en entrée. Prévoyez une documentation en anglais, même si le modèle comprend et rédige le français sans difficulté.
Z.ai a testé GLM-5.3-Flash de façon anonyme sous le nom ox-alpha, sur OpenRouter et OpenCode, avant de révéler son identité. Le but était de récolter des retours sans effet de marque. Le pari a tourné au phénomène, ce modèle mystère est devenu le plus utilisé de la semaine sur la plateforme (des milliers de développeurs l'ont adopté sans savoir qui l'avait fabriqué).
L'éditeur ajoute un détail peu banal, tout ce trafic a été servi sur des puces d'IA chinoises. Une fois le masque tombé, le modèle de 320 milliards de paramètres a été publié en poids ouverts sous licence MIT, téléchargeables sur Hugging Face.
GLM-5.3-Flash active 18 milliards de paramètres sur 320 au total et combine attention creuse et linéaire pour maîtriser le coût des longs contextes. Il dépasse GLM-5.2 sur les benchmarks pour un dixième du prix et frôle Claude Opus 4.8 sur le Code Bench interne de Z.ai. Sur Terminal-Bench, GPT-5.6 Terra et Gemini 3.7 Flash gardent une longueur d'avance, l'écart s'est toutefois nettement resserré. Son score de 57 à l'Artificial Analysis Intelligence Index se vérifie dans un classement des modèles de langage tenu à jour.
Sur le terrain, la multimodalité change la façon de travailler. Vous collez la capture d'un tableau de bord cassé, le modèle voit la mise en page et corrige le code correspondant.
Le chat gratuit de Z.ai fait tourner GLM-5.3-Flash sans carte bancaire. Côté API, la grille affiche 0,15 $ le million de tokens en entrée, 0,50 $ en sortie et 0,03 $ pour le cache, une remise de lancement de 50 % ayant réduit ces montants les premières semaines. En comparaison, GLM-5.3 coûte 1,40 $ et 4,40 $ sur la même page. Ces chiffres bougent vite dans ce secteur, la grille officielle de Z.ai reste la seule référence fiable.
Plusieurs accès coexistent selon votre profil.
| Accès | Ce que vous y faites |
|---|---|
| chat.z.ai | Tester le modèle gratuitement dans le navigateur |
| API Z.ai | L'intégrer à vos applications, facturation au token |
| GLM Coding Plan | L'exploiter dans les agents de code par abonnement |
| OpenRouter | Comparer 17 fournisseurs servant le même modèle |
| Hugging Face | Télécharger les poids ouverts et les adapter |
Non, l'API est facturée au token, mais le chat de Z.ai permet de l'essayer sans rien payer. La période entièrement gratuite correspondait au test anonyme sous le nom Ox Alpha, elle s'est terminée au lancement officiel, remplacée par une remise temporaire de 50 % sur l'API.
Oui, Z.ai a confirmé que le modèle furtif Ox Alpha, apparu sur OpenRouter et OpenCode, était bien GLM-5.3-Flash. Ce test à l'aveugle visait des retours sans biais de marque, et le modèle a fini en tête de l'usage hebdomadaire de la plateforme avant même d'avoir un nom.
Un usage commercial est autorisé sans redevance, la licence MIT couvrant l'exploitation, la modification et la redistribution des poids publiés sur Hugging Face. Vous pouvez donc l'intégrer à un produit payant ou le spécialiser sur vos données, à condition de conserver la mention de licence d'origine.
En local, le point de contrôle FP8 pèse environ 306 Go avant la mémoire d'exécution, ce qui suppose un serveur multi-GPU. Des versions quantisées existent pour réduire la note. Sous un volume d'environ 30 milliards de tokens par mois, l'API revient toutefois moins cher que la location de machines.
Verdict : Dix fois moins cher que GLM-5.3 pour des résultats voisins sur le code, ce modèle vise les développeurs qui font tourner des agents au long cours en surveillant la facture, et les bidouilleurs en quête de poids ouverts sérieux à héberger eux-mêmes.

« Transformez un lien produit, une photo ou une idée en vidéos UGC prêtes à convertir. L'outil combine génération par avatar IA, sous-titres automatiques, amélioration jusqu'en 4K, suppression d'arrière-plan et optimisation visuelle en un seul workflow pensé pour TikTok, Reels et Shopify »